Modelos de IA para detecção de câncer de mama e modelos de predição de risco de curto prazo leem a mesma mamografia, mas não são intercambiáveis. É o que mostra um estudo publicado na Radiology: Imaging Cancer que testou quatro algoritmos em 20.187 mamografias de rastreamento suecas: cada modelo foi melhor na tarefa para a qual foi projetado e perdeu desempenho fora dela. O trabalho foi comentado pela radiologista Manisha Bahl, do Massachusetts General Hospital e da Harvard Medical School, em sua coluna “Breast Imaging in Focus” no Diagnostic Imaging.
O que o estudo avaliou
O artigo, assinado por Yao-Kuan Wang, Lesley Cockmartin, Tobias Wagner e colaboradores, tem como autora sênior Hilde Bosmans e reúne grupos da KU Leuven e do Hospital Universitário de Leuven (Bélgica), da Universidade de Ljubljana e do Instituto Jožef Stefan (Eslovênia) e da Universidade de Wisconsin-Madison. Saiu na edição de setembro de 2026 da revista da RSNA (2026;8(5):e250609).
Trata-se de um estudo retrospectivo do tipo caso-controle. A base reúne 20.187 mamografias de 7.430 mulheres rastreadas na Suécia entre 2008 e 2016. Desses exames, 741 foram seguidos de diagnóstico de câncer de mama em até dois anos: 524 cânceres detectados no próprio rastreamento e 217 cânceres de intervalo, aqueles que aparecem clinicamente entre uma rodada de rastreamento e a seguinte, depois de um exame considerado negativo.
Quatro modelos foram comparados. Dois são de detecção: o Transpara Detection, da ScreenPoint Medical, e um modelo identificado como RSNA Detection. Dois são de risco: o Transpara Risk, também da ScreenPoint, e o Mirai, modelo de risco baseado em imagem desenvolvido no MIT. Cada um rodou em dois cenários. No cenário de detecção entraram os cânceres detectados no rastreamento e os de intervalo. No cenário de risco de curto prazo, o objetivo era apontar, a partir de um exame negativo, quais mulheres teriam câncer de intervalo. As métricas foram a área sob a curva ROC (AUC) e a sensibilidade e a especificidade em limiares clinicamente relevantes.
Os três achados principais
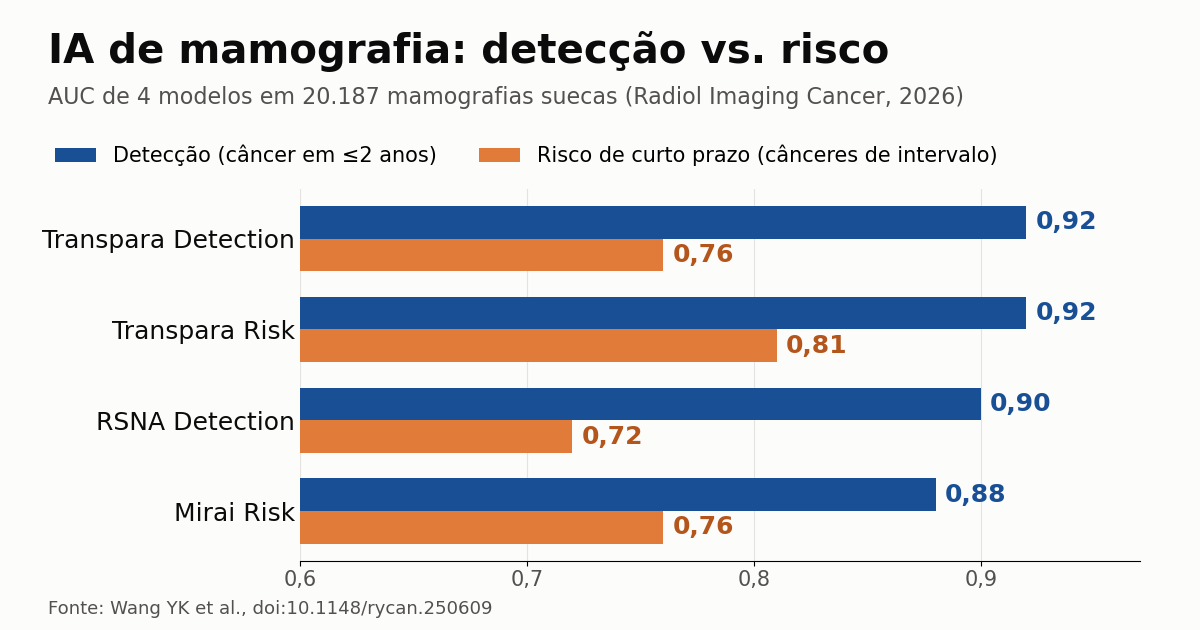
Detecção: o Transpara Detection e o Transpara Risk empataram em AUC de 0,92, à frente do RSNA Detection (0,90) e do Mirai (0,88). O empate, porém, esconde uma diferença operacional. Fixada a sensibilidade na mesma da dupla leitura por radiologistas, de 70,7%, o modelo de detecção alcançou especificidade de 97,1%, contra 94% do modelo de risco. Em um programa de rastreamento, três pontos de especificidade se traduzem em muitas convocações a mais.
Risco de curto prazo: aqui a ordem se inverte. O Transpara Risk teve AUC de 0,81, contra 0,76 do Transpara Detection e do Mirai e 0,72 do RSNA Detection. Com especificidade fixada em 90%, o modelo de risco sinalizou 49,8% dos cânceres de intervalo, enquanto o de detecção sinalizou 41%.
Concordância: os autores cruzaram os dois modelos da ScreenPoint. A 90% de especificidade, apenas 11,1% dos cânceres de intervalo foram apontados pelo modelo de risco sem que o de detecção também os marcasse. E 47,9% dos cânceres de intervalo escaparam dos dois. Ou seja, há bastante sobreposição entre as ferramentas, e quase metade dos casos mais difíceis continua invisível para ambas.
Por que detecção e risco são tarefas diferentes
Um algoritmo de detecção é treinado para localizar o que já está na imagem: massa, distorção arquitetural, microcalcificações. Ele responde à pergunta “há câncer neste exame?”. Um modelo de risco de curto prazo responde a outra pergunta: “esta mulher tende a ter câncer nos próximos anos?”. Para isso, aprende sinais mais difusos, como padrão de densidade, textura do parênquima e assimetrias sutis, que podem anteceder uma lesão visível ou corresponder a um tumor ainda abaixo do limiar de percepção.
Na prática, as duas saídas costumam ser um escore contínuo, e é tentador usar um no lugar do outro. O estudo mostra por que isso é arriscado: AUCs parecidas não garantem o mesmo comportamento no ponto de corte que o serviço vai de fato usar. A AUC resume o desempenho em todos os limiares, mas o programa de rastreamento opera em um só. Essa distinção já apareceu em outras coberturas do blog, como o estudo que usou o Mirai para mapear a evolução do risco de câncer de mama ao longo do tempo e a aposta de investidores em risco baseado em imagem, no caso do fundo da BCRF que investiu na Clairity.
A leitura de Manisha Bahl
Na coluna, Bahl tira três consequências. A primeira é direta: modelos de detecção e de risco não devem ser tratados como intercambiáveis, mesmo quando os números se sobrepõem. A segunda é que a IA de risco pode ajudar a escolher quem se beneficiaria de rastreamento suplementar, mas ainda não se sabe se essa estratégia aumenta a detecção ou reduz os cânceres de intervalo. A terceira diz respeito à combinação das ferramentas: como poucos cânceres de intervalo foram captados só pelo modelo de risco, o ganho incremental de rodar os dois juntos fica em aberto.
A conclusão da radiologista é que se trata de aplicações relacionadas, porém distintas, e que cada modelo deve ser escolhido e validado de acordo com o uso clínico pretendido. Ela defende estudos prospectivos para saber se integrar esses algoritmos ao fluxo de rastreamento melhora desfechos das pacientes.
Implicações para serviços de mama e para o Brasil
Para quem contrata ou implanta IA em mamografia, a mensagem é de governança. Um algoritmo aprovado e validado como detector de lesões não deve ser reaproveitado como estratificador de risco sem validação própria, e o inverso também vale. A escolha do limiar precisa ser feita para a tarefa, considerando a taxa de reconvocação que o serviço consegue absorver. Experiências como a de Estocolmo, que substituiu o segundo radiologista por IA, a redução de carga de trabalho com IA no rastreamento e o ganho de especificidade com a IA da Lunit dizem respeito à detecção. A estratificação de risco é outro produto, com outra validação.
No Brasil, onde o rastreamento organizado ainda é limitado e boa parte das mamografias é oportunística, a estratificação de risco por imagem é atraente porque poderia direcionar recursos escassos, como ultrassonografia complementar ou ressonância, para quem mais precisa. O estudo, porém, não traz dados brasileiros nem latino-americanos. Diferenças de população, de equipamento e de intervalo entre rodadas tornam obrigatória a validação local antes de qualquer uso desse tipo.
Limitações
Bahl e os próprios dados apontam ressalvas importantes. O desenho é retrospectivo e caso-controle, e incluiu vários exames da mesma mulher. Os modelos foram avaliados isoladamente, sem a interação com radiologistas que ocorreria na rotina. Algumas informações clínicas exigidas pelos modelos tiveram de ser imputadas. Todos os exames vieram de um único fabricante de mamógrafo e de uma população sueca, o que limita a generalização. Por fim, o estudo mediu desempenho dos algoritmos, não desfechos clínicos como mortalidade ou estádio ao diagnóstico.
Mesmo assim, o trabalho ajuda a qualificar uma discussão que costuma misturar conceitos. Uma mesma imagem pode alimentar dois tipos de pergunta, e a resposta certa depende de usar a ferramenta certa no ponto de corte certo.
Fonte: Diagnostic Imaging (coluna de Manisha Bahl) e Wang YK et al., Radiology: Imaging Cancer 2026