Um modelo de IA treinado em radiografias de adultos pode ser adaptado a recém-nascidos sem que nenhum hospital compartilhe dados de pacientes. Essa é a principal conclusão de um estudo internacional publicado em 13 de outubro de 2026 na Nature Biomedical Engineering: com aprendizado contínuo (continual learning) entre 30 UTIs neonatais de 20 países e territórios, o erro na localização do tubo endotraqueal e da carina caiu para 0,67 cm, contra 1,29 cm no ajuste fino feito por um único hospital e 4,30 cm quando o modelo adulto era usado sem adaptação.
O problema: IA de adulto não enxerga bem a criança
Os próprios autores lembram, na introdução do artigo, que só cerca de 17% dos modelos comerciais de IA têm liberação da FDA para uso pediátrico, e que crianças representam menos de 1% das imagens disponíveis em bases públicas. A maior parte dos modelos pediátricos publicados vem de um único centro, poucos passam por validação externa e muitos perdem desempenho quando mudam de instituição.
Como contexto geral, os motivos da queda de desempenho são conhecidos na radiologia pediátrica: o tórax de um prematuro tem proporções muito diferentes do adulto, as estruturas são milimétricas, as radiografias são feitas no leito, dentro da incubadora, com fios, eletrodos e cateteres sobrepostos, e os protocolos de exposição são ajustados para dose baixa. A prevalência das alterações também muda. Um algoritmo que nunca viu essa combinação tende a errar, às vezes por vários centímetros. É o mesmo pano de fundo de outros trabalhos que já noticiamos, como a IA que estima densidade óssea em radiografias de tórax de crianças.
Como o estudo foi feito
O trabalho foi liderado por Vishwanatha M. Rao e coordenado por Pranav Rajpurkar, do Departamento de Informática Biomédica da Harvard Medical School, com dezenas de coautores de centros como Stanford, Great Ormond Street (Londres), Universidade Metropolitana de Osaka, Universidade de Cape Town e o comitê de IA da Associação Colombiana de Radiologia, além de um hospital universitário em Manizales, na Colômbia.
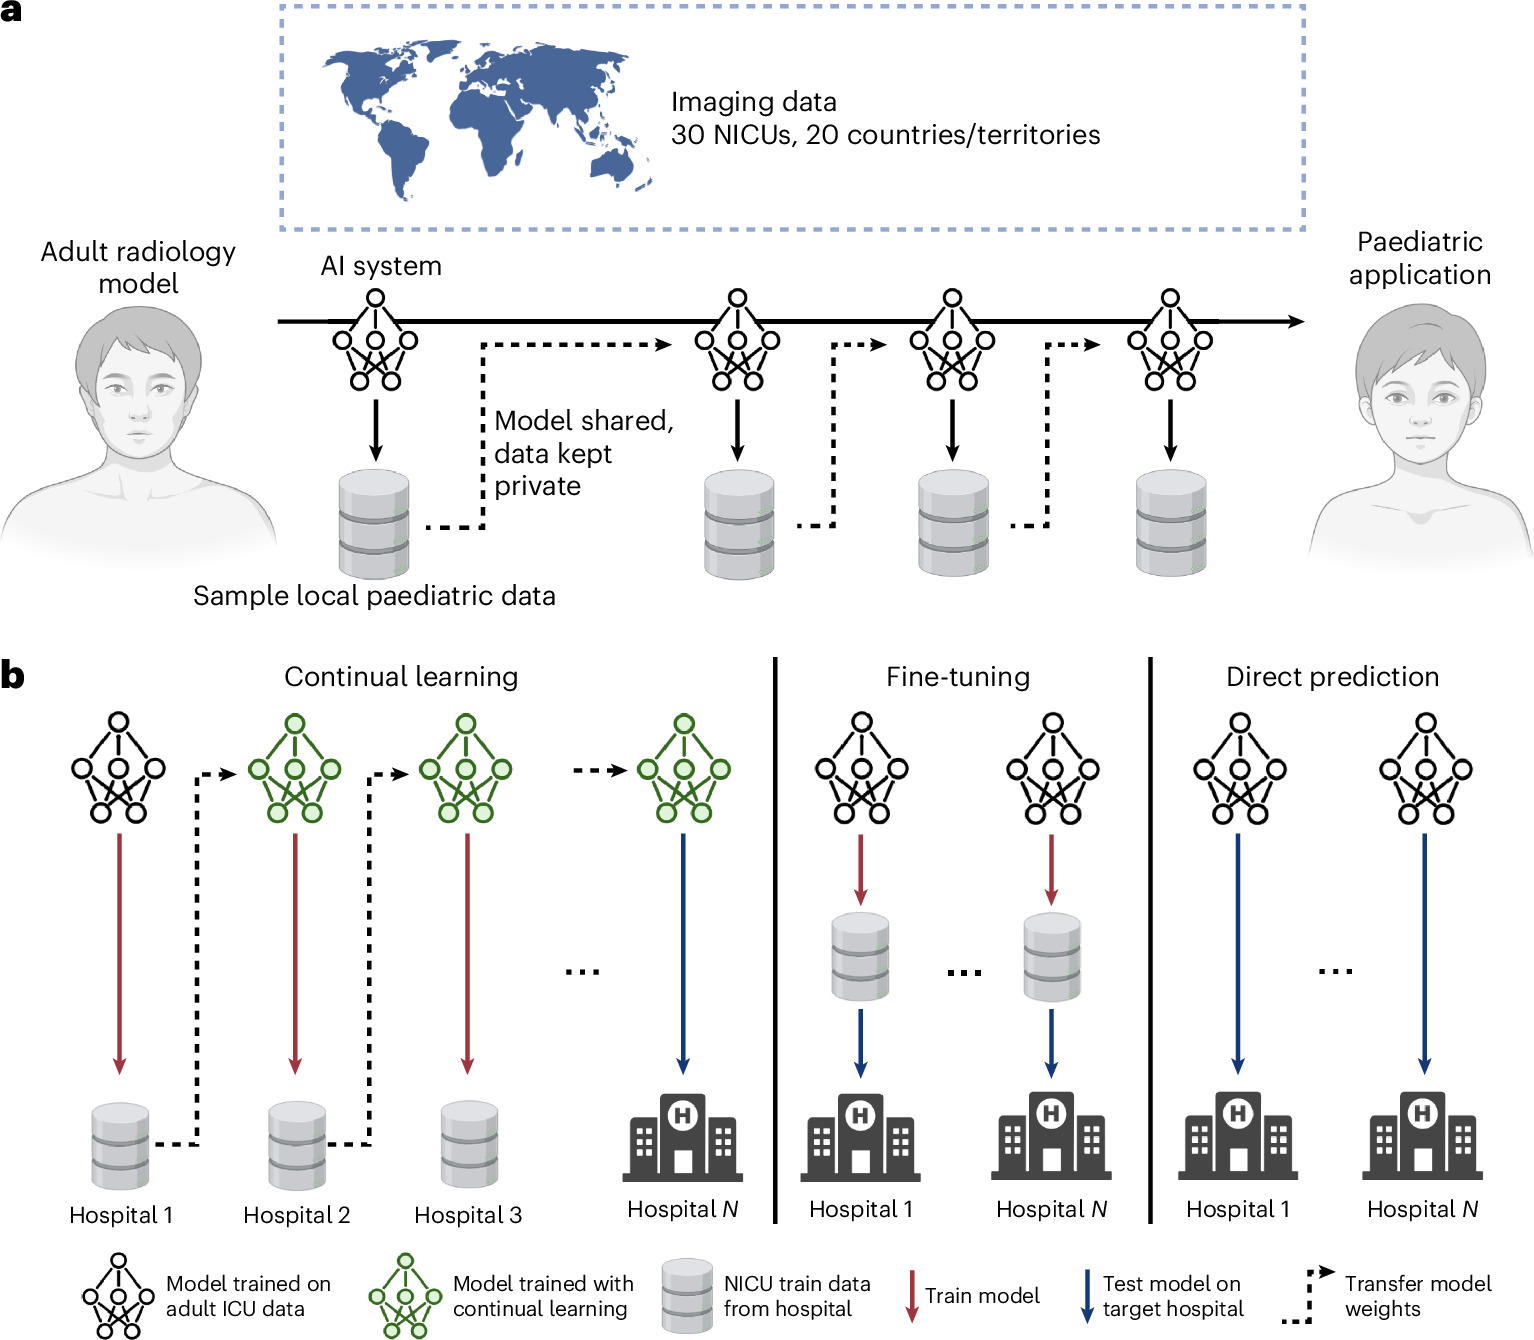
A tarefa escolhida foi a avaliação da posição do tubo endotraqueal, para a qual já existem ferramentas com liberação da FDA em adultos, mas nenhuma solução comercial para neonatos. O ponto de partida foi o CarinaNet, um detector de objetos baseado em RetinaNet com backbone ResNet-50, treinado previamente em 1.890 radiografias de UTI adulta para localizar a ponta do tubo e a carina.
Cada UTI neonatal reuniu cerca de 100 radiografias, com metade de tubos bem posicionados e metade mal posicionados. Cinquenta imagens serviram para treino local e o restante (43 a 53 por centro) para teste. No total foram 2.965 radiografias de 2.960 pacientes, com mediana de idade de 2 dias, peso médio ao nascer de 2.195 g e idade gestacional média de 32,9 semanas, ou seja, uma população majoritariamente prematura.
No aprendizado contínuo, o primeiro hospital recebe o modelo adulto, retreina com suas 50 imagens e repassa apenas os pesos ao próximo, e assim por diante. Os autores compararam essa estratégia a duas alternativas realistas: usar o modelo adulto direto (predição direta) ou ajustá-lo só com os dados do hospital-alvo (ajuste fino). Para cada um dos 30 centros, o hospital avaliado ficou de fora da sequência de treino, e os resultados foram promediados em 10 ordens aleatórias de hospitais. Os experimentos foram executados de forma centralizada para simular o cenário descentralizado.
Os números principais
- Ponta do tubo: erro mediano de 2,35 cm na predição direta, 0,94 cm no ajuste fino e 0,40 cm no aprendizado contínuo.
- Carina: 1,62 cm, 0,27 cm e 0,20 cm, respectivamente.
- Erro combinado: 0,67 cm com aprendizado contínuo; melhora em 29 dos 30 hospitais, com significância estatística em 27.
- Erros extremos (>5 cm): 2,6% dos casos no aprendizado contínuo, 8,2% no ajuste fino e 37,4% na predição direta. O limiar foi escolhido porque 5 cm equivalem a toda a extensão da traqueia de muitos neonatos.
- Triagem de intubação profunda: precisão e recall entre as 15 imagens mais suspeitas melhoraram frente ao ajuste fino em 27 de 30 centros (significativo em 18), com precisão acima de 80% nos melhores hospitais e menos falsos positivos em 18 centros.
Três análises adicionais ajudam a entender o resultado. O modelo não “esqueceu” os hospitais vistos no início da sequência; ao contrário, o desempenho neles melhorou em média 0,48 cm ao fim do processo. O pré-treino em adultos fez diferença: começar de um detector genérico, sem radiografias, deu resultado pior em 25 de 30 centros. E o ganho cresceu com o número de hospitais participantes, sem sinal de platô. Por outro lado, incluir um 31º centro com imagens de baixa resolução piorou o erro combinado (0,75 cm contra 0,67 cm), sugerindo que a qualidade dos dados de cada participante importa.
Por que o método interessa a hospitais e fornecedores
O aprendizado contínuo descrito é, tecnicamente, uma transferência serial de pesos em passagem única, o chamado “modelo viajante”. A diferença em relação ao aprendizado federado é a simplicidade: não exige servidor central, rodadas sincronizadas de comunicação nem infraestrutura homogênea. Os autores imaginam um contêiner de treino entregue a cada hospital, operado pela TI local, com critérios de aceitação pré-definidos e um registro versionado que permita reverter o modelo se houver regressão. Do lado clínico, bastaria curar e anotar algumas dezenas de exames.
Para o Brasil e a América Latina, a proposta conversa diretamente com a LGPD, que torna o envio de imagens de pacientes a terceiros um processo jurídico pesado, e com a realidade de UTIs neonatais com volumes modestos e sem equipe própria de ciência de dados. A participação de centros colombianos mostra que hospitais da região podem entrar em consórcios desse tipo. Também é um lembrete de que a escassez de IA pediátrica aparece nas listas regulatórias: o crescimento das autorizações, discutido em nossa análise sobre a IA em radiologia na FDA, continua concentrado em adultos. E a implantação real tem seus próprios gargalos, como mostramos em IA em radiologia no mundo real.
Limitações e próximos passos
O estudo é retrospectivo e os autores o chamam explicitamente de prova de conceito. Os conjuntos de dados foram balanceados artificialmente (50% de tubos mal posicionados), o que não reflete a prevalência real; a conversão de pixels em centímetros dependeu da largura estimada do tubo, porque o espaçamento de pixel no DICOM era inconsistente entre os centros; e a distância tubo-carina é um indicador fraco para tubos altos, que dependem da relação com a primeira vértebra torácica. A descentralização foi simulada, e modelos que mudam a cada hospital complicam a regulação, já que cada atualização teria de ser compatibilizada com as exigências da FDA e dos comitês locais. Nos prematuros extremos, a margem aceitável de posição do tubo é ainda menor, o que exige validação prospectiva específica.
O próximo passo proposto é integrar o modelo ao fluxo de algumas UTIs participantes para medir o tempo até a confirmação radiológica de tubos mal posicionados, a concordância dos clínicos com os alertas e o impacto em reintubações. Se o modelo se sustentar, a mesma receita poderia ser aplicada a outras tarefas pediátricas em que existe IA para adultos, mas nada para crianças, um tema que se soma às discussões sobre protocolos de imagem pediátrica e sobre comunicação de resultados às famílias.
Fonte: Rao et al., Nature Biomedical Engineering 2026 (doi:10.1038/s41551-026-01812-6), repercutido pelo Health Imaging