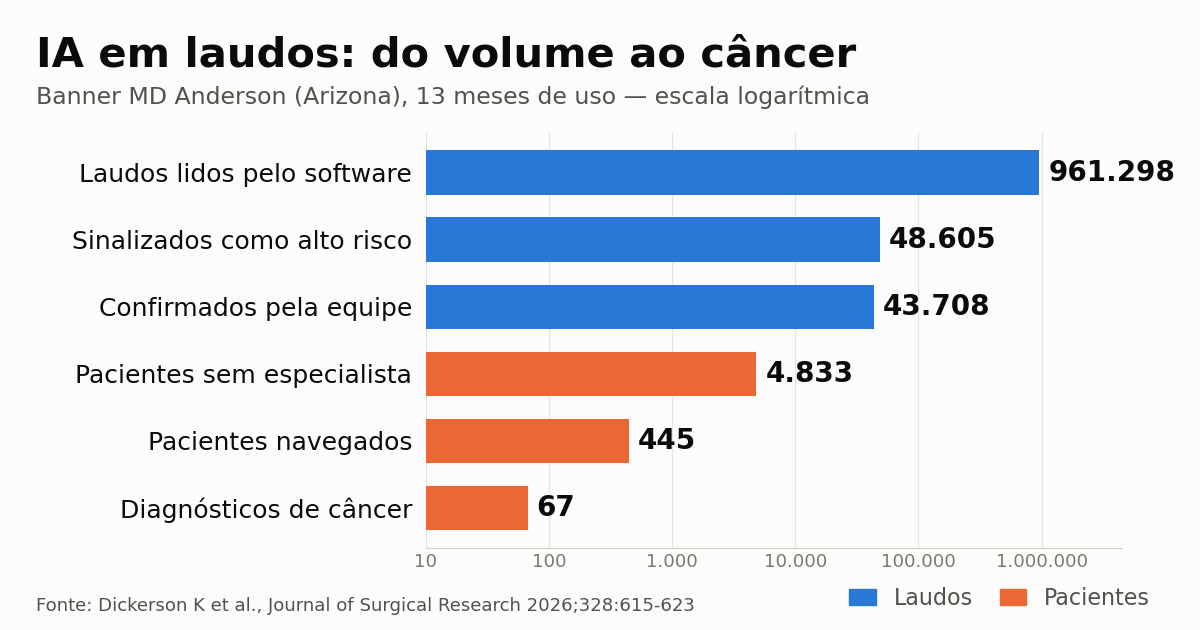
Um programa de inteligência artificial que lê laudos radiológicos já assinados, em busca de achados incidentais de alto risco, levou ao diagnóstico de 67 cânceres de pulmão, fígado e pâncreas em 13 meses no Banner MD Anderson Cancer Center, no Arizona. O estudo, publicado no Journal of Surgical Research, descreve 961.298 laudos analisados pelo software, 43.708 achados confirmados por uma equipe dedicada e 445 pacientes encaminhados a cuidado multidisciplinar. E mostra que a etapa mais estreita do funil não foi a leitura do texto, mas a navegação do paciente até o especialista.
O trabalho é assinado por Kylie Dickerson e colegas do Departamento de Cirurgia da University of Arizona College of Medicine – Phoenix e do Departamento de Oncologia Cirúrgica do Banner MD Anderson. Segundo a reportagem do The Imaging Wire, o software é o da Azra AI, a mesma empresa que em outubro anunciou a compra da plataforma de IA Blackford para atacar o seguimento de achados incidentais. O resumo do artigo não cita o fornecedor: fala apenas em uma solução comercial de processamento de linguagem natural (PLN), de ponta a ponta e voltada à oncologia. Os autores declaram não ter conflitos de interesse nem financiamento.
Como o programa funcionou no Banner Health
O Banner Health é o maior sistema de saúde integrado do Arizona, com 18 hospitais e mais de cem unidades ambulatoriais, segundo o artigo. O software lia em tempo real os laudos de exames feitos em pronto-socorro e em unidades ambulatoriais de imagem e marcava aqueles que descreviam lesões de alto risco para malignidade no pulmão, no fígado e no pâncreas. As palavras-chave e os parâmetros da busca foram definidos pelos pesquisadores. Cada laudo marcado seguia para uma equipe de achados incidentais de alto risco (HRIFT, na sigla em inglês), que o revisava manualmente. Pacientes com achado novo e sem acompanhamento oncológico estabelecido eram contatados e conduzidos até a consulta especializada.
Os números abaixo foram conferidos no resumo indexado no PubMed e nas seções públicas do artigo no ScienceDirect:
- 961.298 laudos analisados pelo software;
- 48.605 (5,1%) marcados como contendo lesão de alto risco;
- 43.708 confirmados pela equipe como achados clinicamente significativos, o que equivale a 89,9% dos marcados e 4,5% de todos os laudos;
- 4.833 pacientes do grupo confirmado sem especialista de referência e, portanto, elegíveis para navegação;
- 445 pacientes navegados com sucesso para cuidado multidisciplinar;
- 67 diagnósticos de câncer: 45 de pulmão (67%), 14 de fígado (21%) e 8 de pâncreas (12%).
Na conclusão, os autores afirmam que a IA identificou um volume de lesões que “teria exigido muito mais tempo para ser investigado pelos meios tradicionais, ou poderia ter passado despercebido”.
O que os percentuais dizem, e o que a cobertura arredondou
Alguns números pedem leitura atenta. A “taxa de falso-positivo de 0,5%” informada pelo estudo, e repetida pela imprensa, usa como denominador o total de laudos analisados: são 4.897 laudos marcados e não confirmados, divididos por 961.298. Medido sobre o que o software efetivamente sinalizou, um em cada dez alertas (10,1%) foi descartado pela revisão humana. É o mesmo dado visto pelo outro lado: um valor preditivo positivo de 89,9%. Para quem precisa dimensionar a equipe de revisão, essa é a métrica que conta.
Os 67 cânceres correspondem a 0,15% dos laudos validados, que o artigo arredonda para 0,2%, e a 15% dos pacientes navegados. O The Imaging Wire escreveu que os clínicos do Banner usaram a ferramenta para revisar os 961 mil laudos; pelo artigo, quem leu esse volume foi o software, e a equipe humana revisou os 48.605 marcados. O resumo traz ainda uma inconsistência que o texto disponível não explica: informa uma janela de 6 de janeiro de 2024 a 30 de junho de 2025, cerca de 18 meses, mas apresenta os resultados como referentes a 13 meses.
O dado que a reportagem deixou de fora talvez seja o mais relevante para a prática. Dos 4.833 pacientes sem especialista de referência, 445 (9,2%) foram navegados com sucesso. O resumo não detalha o que aconteceu com os demais: se recusaram, não foram localizados, buscaram atendimento em outro serviço ou ainda estavam em processo.
Ler o laudo não é ler a imagem
A maior parte da IA em radiologia que chega ao mercado analisa pixels: procura nódulos, hemorragias ou fraturas na própria imagem. O programa do Banner faz outra coisa. Parte do laudo que o radiologista já escreveu e procura, no texto, menções a lesões suspeitas. Portanto, não encontra o que o radiologista deixou de ver; encontra o que foi descrito e corre o risco de não ser acompanhado. É um problema de comunicação e de logística, não de percepção.
Esse elo frágil é conhecido. As recomendações da Fleischner Society para nódulos pulmonares e os white papers do Comitê de Achados Incidentais do American College of Radiology (ACR) para fígado, pâncreas, rins e adrenais definem quando um achado pede controle. Nenhuma diretriz garante, porém, que a recomendação chegue a alguém que vá agir, sobretudo quando o exame foi feito no pronto-socorro e o paciente recebeu alta, ou quando quem pediu a tomografia não é quem acompanha o paciente. Os autores citam um estudo do JAMA Internal Medicine de 2025 segundo o qual 59% a 66% dos pacientes com câncer de pulmão ou colorretal que passaram pela atenção primária nos dois anos anteriores ao diagnóstico tiveram oportunidades perdidas de diagnóstico, com atrasos de 1 a 20 meses. Já discutimos por que o seguimento de nódulo pulmonar não escala e o caso, ainda em disputa judicial, de um nódulo de 8 mm esquecido que virou câncer em estágio 4, em que o achado estava no laudo e o circuito de seguimento falhou.
O processamento de linguagem natural aplicado a laudos tem dificuldades próprias: negações (“sem evidência de lesão”), linguagem hesitante (“não se pode excluir”), lesões já conhecidas e descritas como estáveis, modelos de laudo que repetem frases-padrão. Parte dos 10% de alertas descartados reflete esse tipo de ruído. A sensibilidade, por outro lado, não foi medida: os laudos não marcados não passaram por auditoria, de modo que não se sabe quantos achados de alto risco o software deixou escapar.
O que serviços de imagem no Brasil podem tirar do estudo
O estudo não traz dados brasileiros, mas o problema que descreve aparece em qualquer rede em que o exame é feito em um lugar e o seguimento depende de outro. Três lições saem dos próprios números. A primeira: o software reduziu quase um milhão de laudos a 48,6 mil para revisão, o que ainda significa perto de 3.700 laudos por mês para uma equipe humana. O custo de um programa assim está nas pessoas, não só na licença. A segunda: o gargalo final foi a navegação, não a detecção, o que converge com a experiência de programas que combinam IA e navegação no rastreamento de câncer de pulmão. A terceira: o desempenho depende das palavras-chave e da forma como os laudos são redigidos. Uma ferramenta ajustada para laudos em inglês precisa ser validada com o vocabulário e os hábitos de redação de radiologistas brasileiros antes de qualquer promessa de resultado.
Há também a questão dos dados. Pela LGPD, informações de saúde são dados pessoais sensíveis, e varrer o texto de todos os laudos de uma rede para acionar contato ativo com pacientes exige base legal, governança e definição clara de quem responde pelo alerta. Ferramentas do mesmo segmento, como a Vital Guard, voltada à gestão de achados incidentais, esbarram na mesma pergunta: quem é o responsável pelo achado depois que o laudo é assinado.
Limites do estudo e o que observar a seguir
Trata-se de uma coorte em um único sistema de saúde, sem grupo controle e sem comparação com o período anterior à implantação. Não há como saber quantos dos 67 cânceres teriam sido diagnosticados de qualquer forma, nem se foram encontrados em estágio mais precoce: o resumo não informa estadiamento nem tempo até o diagnóstico. A análise se limita a pulmão, fígado e pâncreas, e o texto completo está atrás de paywall; esta reportagem se baseia no resumo e nas seções públicas do artigo.
Mesmo assim, o trabalho oferece algo raro nesse segmento: números revisados por pares, na escala de um sistema inteiro, para uma categoria de produto que até aqui circulava sobretudo com dados de fornecedores. O que daria mais peso ao modelo são comparações antes e depois da implantação, medidas de tempo até o tratamento e de estadiamento ao diagnóstico, e auditorias de amostras de laudos não marcados para estimar a sensibilidade.
Fonte: The Imaging Wire — AI Finds Overlooked Cancers in Radiology Reports. Artigo original: Dickerson K et al., Artificial Intelligence Guided Navigation of High-Risk Incidental Findings on Imaging Studies Leads to Cancer Diagnoses, Journal of Surgical Research, 2026.