Los modelos de IA para detección de cáncer de mama y los de predicción de riesgo a corto plazo leen la misma mamografía, pero no son intercambiables. Así lo muestra un estudio publicado en Radiology: Imaging Cancer que probó cuatro algoritmos en 20.187 mamografías de cribado suecas: cada modelo rindió mejor en la tarea para la que fue diseñado y perdió desempeño fuera de ella. El trabajo fue comentado por la radióloga Manisha Bahl, del Massachusetts General Hospital y la Harvard Medical School, en su columna «Breast Imaging in Focus» de Diagnostic Imaging.
Qué evaluó el estudio
El artículo, firmado por Yao-Kuan Wang, Lesley Cockmartin, Tobias Wagner y colaboradores, con Hilde Bosmans como autora sénior, reúne grupos de la KU Leuven y el Hospital Universitario de Lovaina (Bélgica), la Universidad de Liubliana y el Instituto Jožef Stefan (Eslovenia) y la Universidad de Wisconsin-Madison. Se publicó en el número de septiembre de 2026 de la revista de la RSNA (2026;8(5):e250609).
Es un estudio retrospectivo de casos y controles. La base reúne 20.187 mamografías de 7.430 mujeres cribadas en Suecia entre 2008 y 2016. De esos estudios, 741 fueron seguidos de un diagnóstico de cáncer de mama en un plazo de dos años: 524 cánceres detectados en el propio cribado y 217 cánceres de intervalo, es decir, los que aparecen clínicamente entre una ronda de cribado y la siguiente, después de un examen considerado negativo.
Se compararon cuatro modelos. Dos son de detección: Transpara Detection, de ScreenPoint Medical, y un modelo identificado como RSNA Detection. Dos son de riesgo: Transpara Risk, también de ScreenPoint, y Mirai, el modelo de riesgo basado en imagen desarrollado en el MIT. Cada uno se evaluó en dos escenarios. El de detección incluyó los cánceres detectados en el cribado y los de intervalo. El de riesgo a corto plazo buscaba identificar, a partir de un examen negativo, qué mujeres tendrían un cáncer de intervalo. Las métricas fueron el área bajo la curva ROC (AUC) y la sensibilidad y especificidad en umbrales clínicamente relevantes.
Los tres hallazgos principales
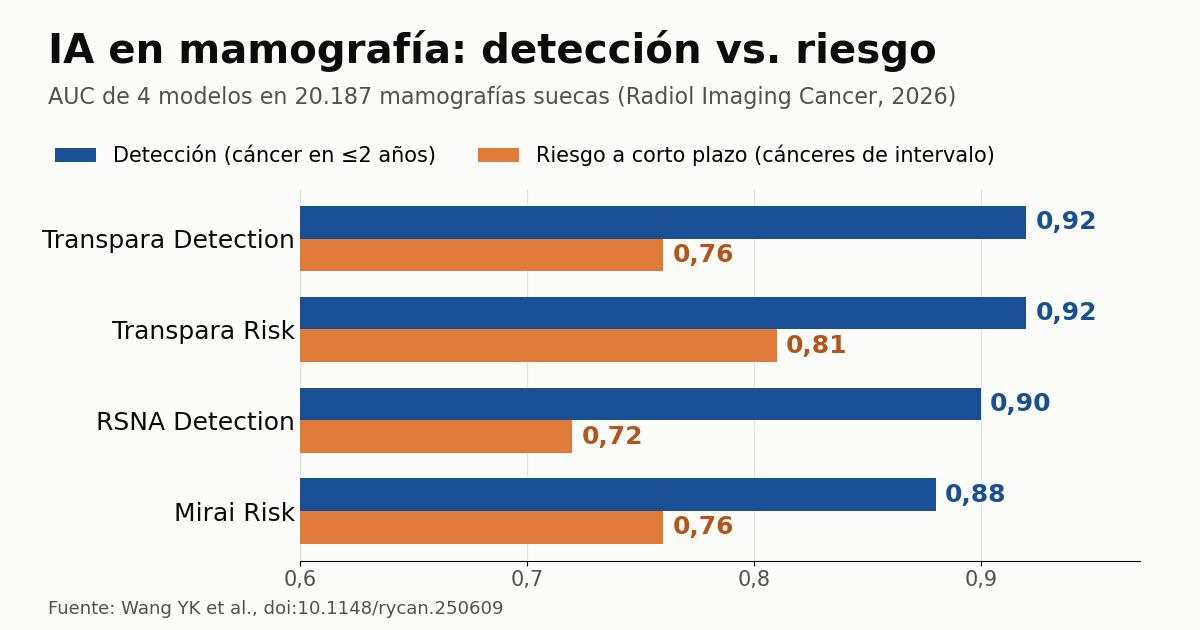
Detección: Transpara Detection y Transpara Risk empataron con un AUC de 0,92, por delante de RSNA Detection (0,90) y Mirai (0,88). El empate, sin embargo, oculta una diferencia operativa. Con la sensibilidad fijada en la de la doble lectura por radiólogos, del 70,7%, el modelo de detección alcanzó una especificidad del 97,1%, frente al 94% del modelo de riesgo. En un programa de cribado, tres puntos de especificidad equivalen a muchas rellamadas adicionales.
Riesgo a corto plazo: aquí el orden se invierte. Transpara Risk obtuvo un AUC de 0,81, frente a 0,76 de Transpara Detection y de Mirai y 0,72 de RSNA Detection. Con la especificidad fijada en el 90%, el modelo de riesgo señaló el 49,8% de los cánceres de intervalo, mientras que el de detección señaló el 41%.
Concordancia: los autores cruzaron los dos modelos de ScreenPoint. Al 90% de especificidad, solo el 11,1% de los cánceres de intervalo fue señalado por el modelo de riesgo sin que el de detección también lo marcara, y el 47,9% escapó a ambos. Es decir, hay mucha superposición entre las herramientas y casi la mitad de los casos más difíciles sigue siendo invisible para las dos.
Por qué detección y riesgo son tareas distintas
Un algoritmo de detección se entrena para localizar lo que ya está en la imagen: masa, distorsión arquitectural, microcalcificaciones. Responde a la pregunta «¿hay cáncer en este estudio?». Un modelo de riesgo a corto plazo responde a otra: «¿es probable que esta mujer desarrolle cáncer en los próximos años?». Para ello aprende señales más difusas, como el patrón de densidad, la textura del parénquima y asimetrías sutiles, que pueden anteceder a una lesión visible o corresponder a un tumor todavía por debajo del umbral de percepción.
Ambas salidas suelen ser una puntuación continua, y es tentador usar una en lugar de la otra. El estudio muestra por qué eso es arriesgado: AUC parecidos no garantizan el mismo comportamiento en el punto de corte que el servicio usará de verdad. El AUC resume el desempeño en todos los umbrales, pero un programa de cribado opera en uno solo. Esta distinción ya apareció en otras coberturas del blog, como el estudio que usó Mirai para seguir la evolución del riesgo de cáncer de mama y el interés de inversores en el riesgo basado en imagen, en el caso del fondo de la BCRF que invirtió en Clairity.
La lectura de Manisha Bahl
En su columna, Bahl extrae tres consecuencias. La primera es directa: los modelos de detección y de riesgo no deben tratarse como intercambiables, aunque sus cifras se superpongan. La segunda es que la IA de riesgo podría ayudar a seleccionar a las mujeres que se beneficiarían de un cribado suplementario, pero aún no se sabe si esa estrategia aumenta la detección o reduce los cánceres de intervalo. La tercera se refiere a combinar las herramientas: como pocos cánceres de intervalo fueron captados solo por el modelo de riesgo, el beneficio incremental de usar ambos sigue abierto.
Su conclusión es que se trata de aplicaciones relacionadas pero distintas, y que cada modelo debe elegirse y validarse según el uso clínico previsto. La radióloga pide estudios prospectivos para saber si integrar estos algoritmos en el flujo de cribado mejora los resultados de las pacientes.
Implicaciones para los servicios de mama en América Latina
Para quien contrata o implementa IA en mamografía, el mensaje es de gobernanza. Un algoritmo aprobado y validado como detector de lesiones no debe reutilizarse como estratificador de riesgo sin una validación propia, y lo inverso también vale. El umbral debe elegirse para la tarea, teniendo en cuenta la tasa de rellamadas que el servicio puede absorber. Experiencias como la de Estocolmo, que sustituyó al segundo lector por IA, la reducción de carga de trabajo con IA en el cribado y la mejora de especificidad con la IA de Lunit se refieren a la detección. La estratificación de riesgo es otro producto, con otra validación.
En gran parte de América Latina, donde el cribado organizado todavía es limitado y muchas mamografías son oportunistas, la estratificación de riesgo por imagen resulta atractiva porque podría dirigir recursos escasos, como la ecografía complementaria o la resonancia, a quienes más los necesitan. El estudio, sin embargo, no incluye datos latinoamericanos. Las diferencias de población, equipos e intervalo entre rondas hacen obligatoria la validación local antes de cualquier uso de este tipo.
Limitaciones
Bahl y los propios datos señalan reservas importantes. El diseño es retrospectivo de casos y controles e incluyó varios estudios de una misma mujer. Los modelos se evaluaron de forma aislada, sin la interacción con radiólogos que ocurriría en la rutina. Parte de la información clínica que requieren los modelos tuvo que imputarse. Todos los estudios provinieron de un único fabricante de mamógrafos y de una población sueca, lo que limita la generalización. Por último, el estudio midió el desempeño de los algoritmos, no resultados clínicos como mortalidad o estadio al diagnóstico.
Aun así, el trabajo ayuda a afinar una discusión que suele mezclar conceptos. Una misma imagen puede alimentar dos preguntas distintas, y la respuesta correcta depende de usar la herramienta adecuada en el punto de corte adecuado.
Fuente: Diagnostic Imaging (columna de Manisha Bahl) y Wang YK et al., Radiology: Imaging Cancer 2026