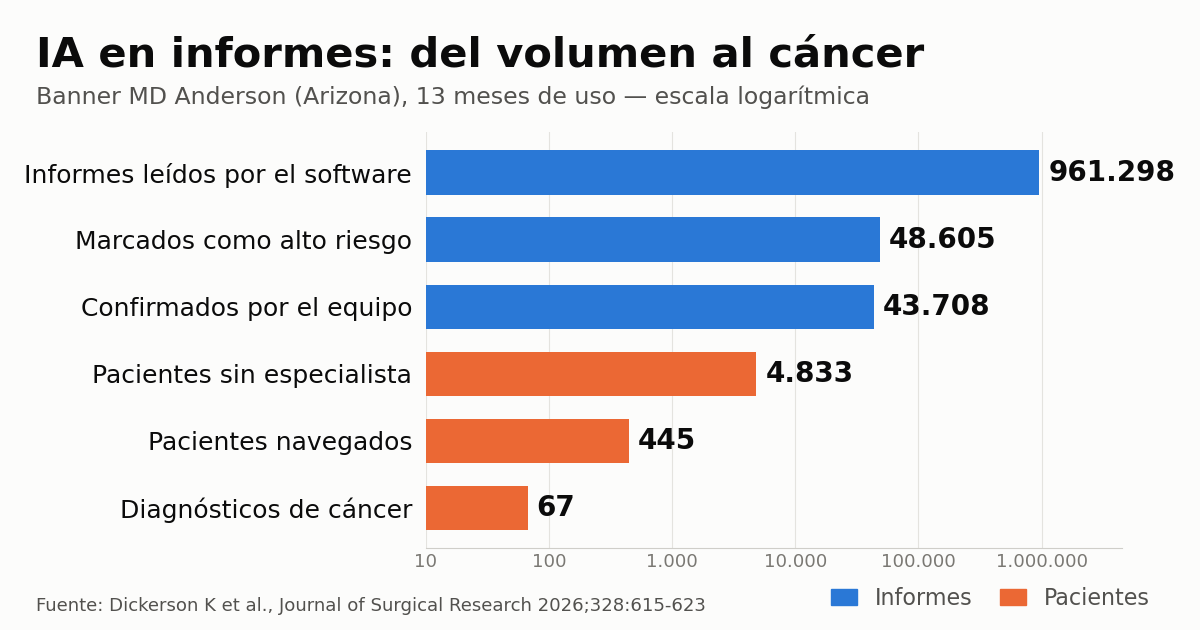
Un programa de inteligencia artificial que lee informes radiológicos ya firmados, en busca de hallazgos incidentales de alto riesgo, condujo al diagnóstico de 67 cánceres de pulmón, hígado y páncreas en 13 meses en el Banner MD Anderson Cancer Center, en Arizona. El estudio, publicado en el Journal of Surgical Research, describe 961.298 informes analizados por el software, 43.708 hallazgos confirmados por un equipo dedicado y 445 pacientes derivados a atención multidisciplinaria. También muestra que el punto más estrecho del embudo no fue leer el texto, sino llevar al paciente hasta el especialista.
El trabajo lo firman Kylie Dickerson y colegas del Departamento de Cirugía de la University of Arizona College of Medicine – Phoenix y del Departamento de Oncología Quirúrgica de Banner MD Anderson. Según The Imaging Wire, el software es el de Azra AI, la empresa que en octubre anunció la compra de la plataforma de IA Blackford para reforzar el seguimiento de hallazgos incidentales. El resumen del artículo no nombra al proveedor: habla de una solución comercial de procesamiento de lenguaje natural (PLN), integral y orientada a oncología. Los autores declaran no tener conflictos de interés ni financiación.
Cómo funcionó el programa en Banner Health
Banner Health es el mayor sistema de salud integrado de Arizona, con 18 hospitales y más de cien centros ambulatorios, según el artículo. El software leía en tiempo real los informes de estudios realizados en urgencias y en centros ambulatorios de imagen, y marcaba los que describían lesiones de alto riesgo de malignidad en pulmón, hígado y páncreas. Los investigadores definieron las palabras clave y los parámetros de búsqueda. Cada informe marcado pasaba a un equipo de hallazgos incidentales de alto riesgo (HRIFT, por su sigla en inglés), que lo revisaba manualmente. Los pacientes con un hallazgo nuevo y sin atención oncológica establecida eran contactados y guiados hasta la consulta especializada.
Verificamos las cifras siguientes en el resumen indexado en PubMed y en las secciones públicas del artículo en ScienceDirect:
- 961.298 informes analizados por el software;
- 48.605 (5,1%) marcados por contener una lesión de alto riesgo;
- 43.708 confirmados por el equipo como hallazgos clínicamente significativos, es decir, el 89,9% de los marcados y el 4,5% de todos los informes;
- 4.833 pacientes del grupo confirmado sin especialista de referencia y, por lo tanto, candidatos a navegación;
- 445 pacientes navegados con éxito hacia atención multidisciplinaria;
- 67 diagnósticos de cáncer: 45 de pulmón (67%), 14 de hígado (21%) y 8 de páncreas (12%).
En sus conclusiones, los autores sostienen que la IA identificó un volumen de lesiones que «habría requerido mucho más tiempo para ser estudiado por los medios tradicionales, o podría haber pasado inadvertido».
Qué dicen los porcentajes y qué redondeó la cobertura
Algunas cifras requieren lectura cuidadosa. La «tasa de falsos positivos del 0,5%» que informa el estudio, y que repitió la prensa, usa como denominador el total de informes analizados: 4.897 informes marcados y no confirmados, divididos por 961.298. Si se mide sobre lo que el software realmente señaló, una de cada diez alertas (10,1%) fue descartada en la revisión humana. Visto desde el otro lado, es un valor predictivo positivo del 89,9%. Para dimensionar el equipo de revisión, esa es la métrica relevante.
Los 67 cánceres equivalen al 0,15% de los informes validados, que el artículo redondea a 0,2%, y al 15% de los pacientes navegados. The Imaging Wire escribió que los clínicos de Banner usaron la herramienta para revisar los 961.000 informes; según el artículo, quien leyó ese volumen fue el software, y el equipo humano revisó los 48.605 marcados. El resumen contiene además una inconsistencia que el texto disponible no aclara: indica un periodo del 6 de enero de 2024 al 30 de junio de 2025, unos 18 meses, pero presenta los resultados como correspondientes a 13 meses.
El dato que omitió la nota de prensa quizá sea el más útil para la práctica. De los 4.833 pacientes sin especialista de referencia, 445 (9,2%) fueron navegados con éxito. El resumen no detalla qué pasó con los demás: si se negaron, no fueron localizados, se atendieron en otro centro o seguían en proceso.
Leer el informe no es leer la imagen
La mayor parte de la IA comercial en radiología analiza píxeles: busca nódulos, hemorragias o fracturas en la propia imagen. El programa de Banner hace otra cosa. Parte del informe que el radiólogo ya firmó y busca en el texto descripciones de lesiones sospechosas. No encuentra lo que el radiólogo no vio; encuentra lo que se describió y corre el riesgo de quedar sin seguimiento. Es una herramienta de comunicación y logística, no de percepción.
Ese eslabón débil es conocido. Las recomendaciones de la Fleischner Society para nódulos pulmonares y los white papers del Comité de Hallazgos Incidentales del American College of Radiology (ACR) para hígado, páncreas, riñones y suprarrenales indican cuándo un hallazgo requiere control. Ninguna guía asegura, sin embargo, que la recomendación llegue a alguien que vaya a actuar, sobre todo cuando el estudio se hizo en urgencias y el paciente ya recibió el alta, o cuando quien pidió la tomografía no es quien sigue al paciente. Los autores citan un estudio de JAMA Internal Medicine de 2025 según el cual entre el 59% y el 66% de los pacientes con cáncer de pulmón o colorrectal que habían pasado por atención primaria en los dos años previos al diagnóstico tuvieron oportunidades diagnósticas perdidas, con demoras de 1 a 20 meses. Ya analizamos por qué el seguimiento del nódulo pulmonar no escala y una demanda todavía en curso por un nódulo de 8 mm olvidado que terminó en cáncer en estadio 4, en la que el hallazgo figuraba en el informe y el circuito de seguimiento falló.
El PLN aplicado a informes tiene dificultades propias: negaciones («sin evidencia de lesión»), lenguaje dubitativo («no puede descartarse»), lesiones conocidas descritas como estables y plantillas que repiten frases hechas. Parte del 10% de alertas descartadas probablemente refleja ese ruido. La sensibilidad, en cambio, no se midió: los informes no marcados no se auditaron, así que no se sabe cuántos hallazgos de alto riesgo se le escaparon al software.
Qué pueden aprender los servicios de imagen en América Latina
El estudio no incluye datos latinoamericanos, pero el problema que describe aparece en cualquier red donde el estudio se hace en un lugar y el seguimiento depende de otro. De las cifras salen tres lecciones. Primera: el software redujo casi un millón de informes a 48.600 para revisión, lo que todavía supone unos 3.700 informes al mes para un equipo humano. El costo de un programa así está en las personas, no solo en la licencia. Segunda: el cuello de botella final fue la navegación y no la detección, en línea con la experiencia de programas que combinan IA y navegación en el cribado de cáncer de pulmón. Tercera: el rendimiento depende de las palabras clave y de cómo redactan los radiólogos. Una herramienta ajustada a informes en inglés debe validarse con el vocabulario y los hábitos de redacción locales, en español o en portugués, antes de prometer resultados parecidos.
También está la cuestión de los datos. La mayoría de las leyes de protección de datos de la región, como la LGPD brasileña, tratan la información de salud como dato sensible, y recorrer el texto de todos los informes de una red para contactar activamente a pacientes exige base legal, gobernanza y una definición clara de quién responde por cada alerta. Herramientas del mismo segmento, como Vital Guard, orientada a gestionar hallazgos incidentales o la IA agéntica que identifica pacientes para seguimiento, chocan con la misma pregunta: quién es responsable del hallazgo una vez firmado el informe.
Límites del estudio y qué observar
Se trata de una cohorte en un único sistema de salud, sin grupo control ni comparación con el periodo previo a la implementación. No es posible saber cuántos de los 67 cánceres se habrían diagnosticado de todos modos, ni si se detectaron en un estadio más temprano: el resumen no informa estadificación ni tiempo hasta el diagnóstico. El análisis se limita a pulmón, hígado y páncreas, y el texto completo es de pago; esta nota se basa en el resumen y en las secciones públicas del artículo.
Aun así, el trabajo aporta algo poco común en este segmento: cifras revisadas por pares, a escala de un sistema completo, para una categoría de producto que hasta ahora circulaba sobre todo con datos de los proveedores. Lo que daría más solidez al modelo serían comparaciones antes y después de la implementación, mediciones de tiempo hasta el tratamiento y de estadio al diagnóstico, y auditorías de muestras de informes no marcados para estimar la sensibilidad.
Fuente: The Imaging Wire — AI Finds Overlooked Cancers in Radiology Reports. Artículo original: Dickerson K et al., Artificial Intelligence Guided Navigation of High-Risk Incidental Findings on Imaging Studies Leads to Cancer Diagnoses, Journal of Surgical Research, 2026.