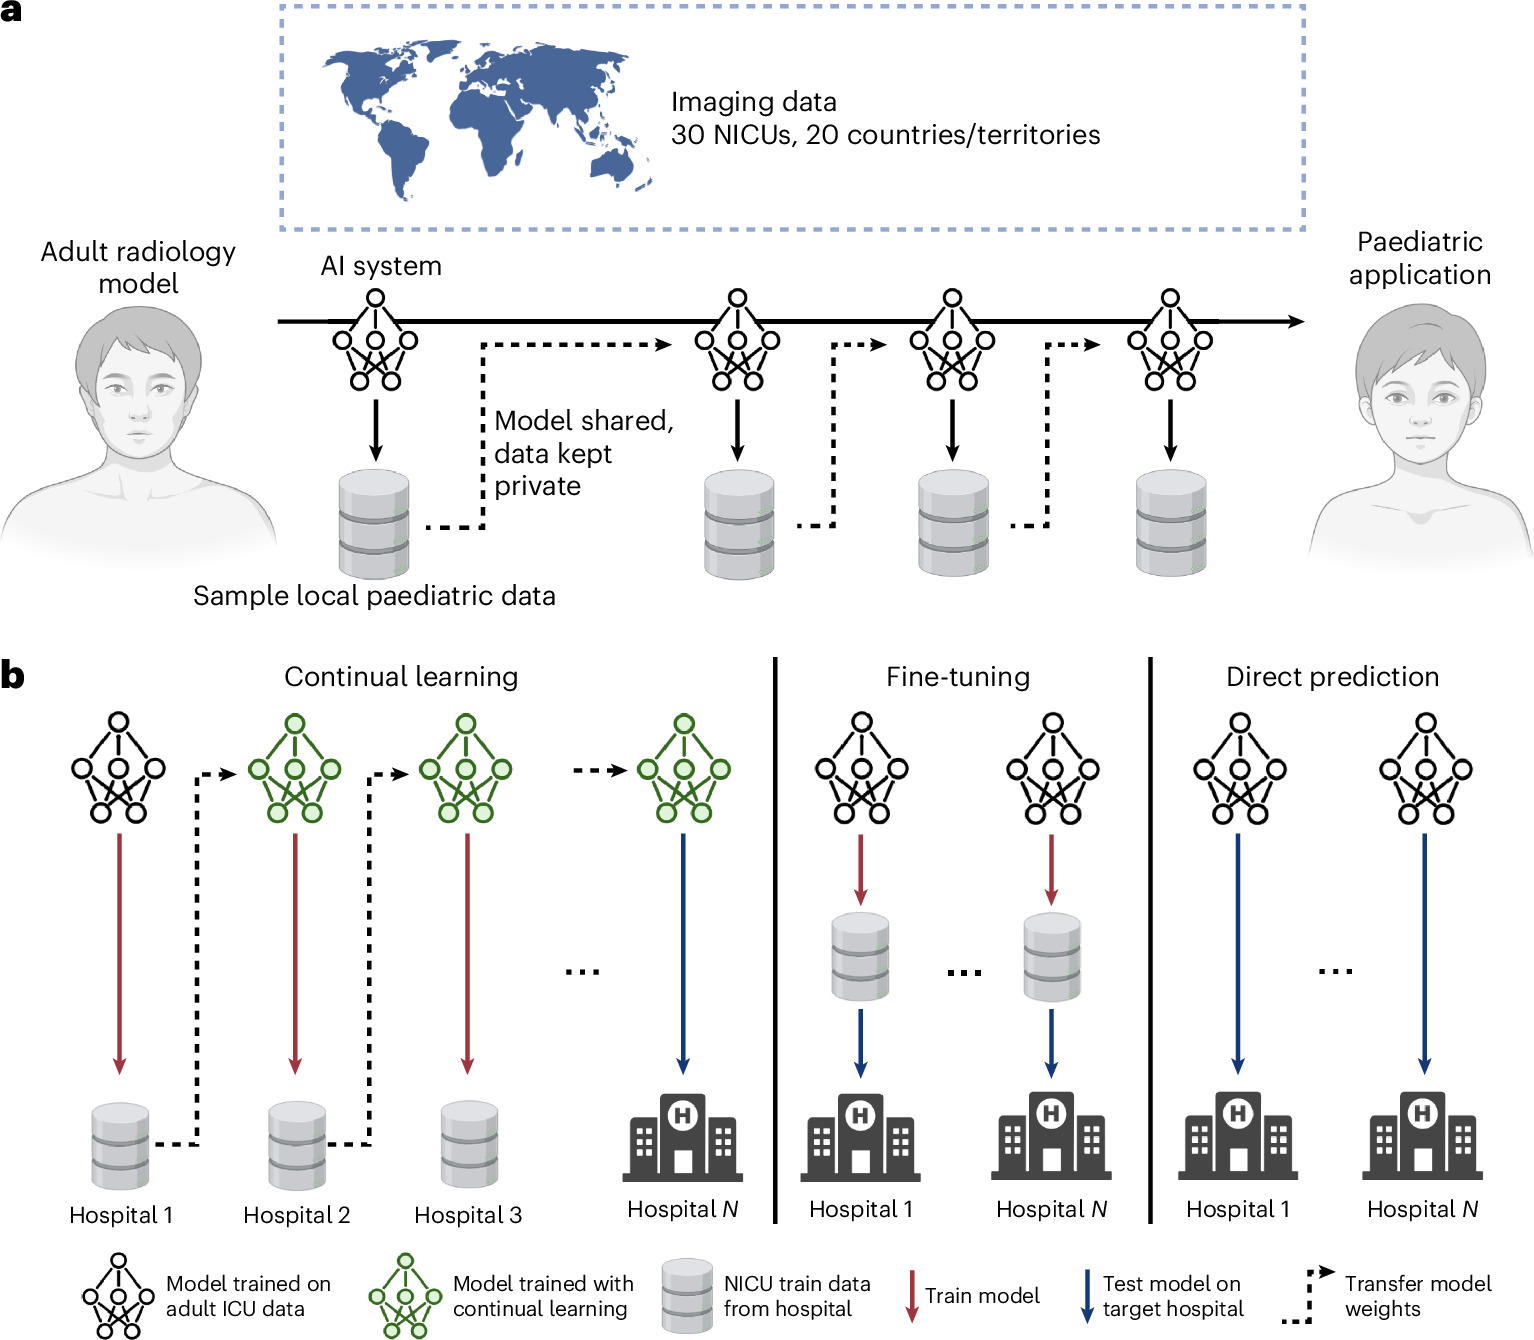
Un modelo de IA entrenado con radiografías de adultos puede adaptarse a recién nacidos sin que ningún hospital comparta datos de pacientes. Esa es la conclusión central de un estudio internacional publicado el 13 de octubre de 2026 en Nature Biomedical Engineering: con aprendizaje continuo (continual learning) entre 30 unidades de cuidados intensivos neonatales (UCIN) de 20 países y territorios, el error al localizar la punta del tubo endotraqueal y la carina bajó a 0,67 cm, frente a 1,29 cm con ajuste fino en un solo hospital y 4,30 cm cuando se usaba el modelo adulto sin adaptación.
El problema: la IA de adultos no lee bien al niño
Los autores recuerdan que solo alrededor del 17% de los modelos comerciales de IA tiene autorización de la FDA para uso pediátrico y que los niños representan menos del 1% de las imágenes de bases públicas. La mayoría de los modelos pediátricos publicados proviene de un único centro, pocos tienen validación externa y muchos pierden rendimiento al cambiar de institución.
Como contexto general, las razones de esa caída son conocidas en radiología pediátrica. El tórax de un prematuro tiene proporciones muy distintas al del adulto, las estructuras son milimétricas, las placas se toman en la cama, dentro de la incubadora, con cables, electrodos y catéteres superpuestos, y los protocolos de exposición se ajustan a dosis baja. La prevalencia de las alteraciones también cambia. Un algoritmo que nunca vio esa combinación puede equivocarse por varios centímetros. Es el mismo trasfondo de otros trabajos que publicamos, como la IA que estima la densidad ósea en radiografías de tórax de niños.
Cómo se hizo el estudio
El trabajo fue liderado por Vishwanatha M. Rao y coordinado por Pranav Rajpurkar, del Departamento de Informática Biomédica de la Harvard Medical School, con decenas de coautores de centros como Stanford, Great Ormond Street (Londres), la Universidad Metropolitana de Osaka, la Universidad de Ciudad del Cabo y el comité de IA de la Asociación Colombiana de Radiología, además de un hospital universitario de Manizales, Colombia.
La tarea elegida fue evaluar la posición del tubo endotraqueal, para la cual ya existen herramientas autorizadas por la FDA en adultos, pero ninguna solución comercial para neonatos. El punto de partida fue CarinaNet, un detector de objetos basado en RetinaNet con backbone ResNet-50, entrenado previamente con 1.890 radiografías de UCI adulta para ubicar la punta del tubo y la carina.
Cada UCIN reunió unas 100 radiografías, con la mitad de tubos bien posicionados y la mitad mal posicionados. Cincuenta imágenes se usaron para entrenamiento local y el resto (43 a 53 por centro) para prueba. En total fueron 2.965 radiografías de 2.960 pacientes, con mediana de edad de 2 días, peso medio al nacer de 2.195 g y edad gestacional media de 32,9 semanas, una población mayoritariamente prematura.
En el aprendizaje continuo, el primer hospital recibe el modelo adulto, lo reentrena con sus 50 imágenes y pasa solo los pesos al siguiente, y así sucesivamente. Los autores lo compararon con dos alternativas realistas: usar el modelo adulto tal cual (predicción directa) o ajustarlo solo con los datos del hospital evaluado (ajuste fino). Para cada uno de los 30 centros, el hospital evaluado quedó fuera de la secuencia de entrenamiento y los resultados se promediaron en 10 órdenes aleatorios. Los experimentos se ejecutaron de forma centralizada para simular el escenario descentralizado.
Los resultados principales
- Punta del tubo: error mediano de 2,35 cm con predicción directa, 0,94 cm con ajuste fino y 0,40 cm con aprendizaje continuo.
- Carina: 1,62 cm, 0,27 cm y 0,20 cm, respectivamente.
- Error combinado: 0,67 cm con aprendizaje continuo; mejora en 29 de 30 hospitales, con significancia estadística en 27.
- Errores extremos (>5 cm): 2,6% de los casos con aprendizaje continuo, 8,2% con ajuste fino y 37,4% con predicción directa. El umbral se eligió porque 5 cm equivalen a toda la longitud traqueal de muchos neonatos.
- Triaje de intubaciones profundas: la precisión y el recall entre las 15 placas más sospechosas mejoraron frente al ajuste fino en 27 de 30 centros (significativo en 18), con precisión superior al 80% en los mejores hospitales y menos falsos positivos en 18 centros.
Tres análisis adicionales ayudan a entender el resultado. El modelo no «olvidó» los hospitales vistos al inicio de la secuencia; al contrario, su rendimiento en ellos mejoró en promedio 0,48 cm al final. El preentrenamiento con adultos fue relevante: partir de un detector genérico, sin radiografías, rindió peor en 25 de 30 centros. Y la ganancia creció con el número de hospitales, sin señales de meseta. En cambio, incluir un centro 31 con imágenes de baja resolución empeoró el error combinado (0,75 cm frente a 0,67 cm), lo que indica que la calidad de los datos de cada participante importa.
Por qué el método interesa a hospitales y proveedores
Técnicamente, se trata de una transferencia serial de pesos en una sola pasada, el llamado «modelo viajero». Su ventaja frente al aprendizaje federado es la simplicidad: no requiere servidor central, rondas sincronizadas de comunicación ni infraestructura homogénea. Los autores imaginan un contenedor de entrenamiento enviado a cada hospital, operado por el área de TI local con criterios de aceptación predefinidos y un registro versionado que permita revertir el modelo ante una regresión. Del lado clínico, bastaría con curar y anotar algunas decenas de estudios.
Para América Latina, la propuesta encaja con leyes de protección de datos cada vez más exigentes y con UCIN de volumen moderado y sin equipos propios de ciencia de datos. La participación de centros colombianos muestra que hospitales de la región pueden integrarse a consorcios de este tipo. También recuerda que la IA pediátrica sigue siendo escasa en las listas regulatorias: el crecimiento de autorizaciones que analizamos en IA en radiología en la FDA sigue concentrado en adultos, y la implementación real tiene sus propios cuellos de botella, como mostramos en IA en radiología en el mundo real.
Limitaciones y próximos pasos
El estudio es retrospectivo y los autores lo definen como prueba de concepto. Los conjuntos se balancearon artificialmente con cerca de 50% de tubos mal posicionados, lo que no refleja la prevalencia real; la conversión de píxeles a centímetros dependió del ancho estimado del tubo, porque el espaciado de píxel en DICOM era inconsistente entre centros; y la distancia tubo-carina es un indicador débil para tubos altos, que se definen respecto de la primera vértebra torácica. La descentralización fue simulada, y un modelo que cambia en cada hospital complica la regulación, ya que cada actualización debe conciliarse con la FDA y los comités locales. En prematuros extremos el margen aceptable es aún menor, lo que exige validación prospectiva específica.
El siguiente paso propuesto es integrar el modelo al flujo de algunas UCIN participantes para medir el tiempo hasta la confirmación radiológica de tubos mal posicionados, la concordancia de los clínicos con las alertas y el efecto en las reintubaciones. Si se confirma, la misma receta podría aplicarse a otras tareas pediátricas en las que existe IA para adultos, pero nada para niños, un tema que se suma a debates como el de la RM rápida en el TCE infantil.
Fuente: Rao et al., Nature Biomedical Engineering 2026 (doi:10.1038/s41551-026-01812-6), difundido por Health Imaging