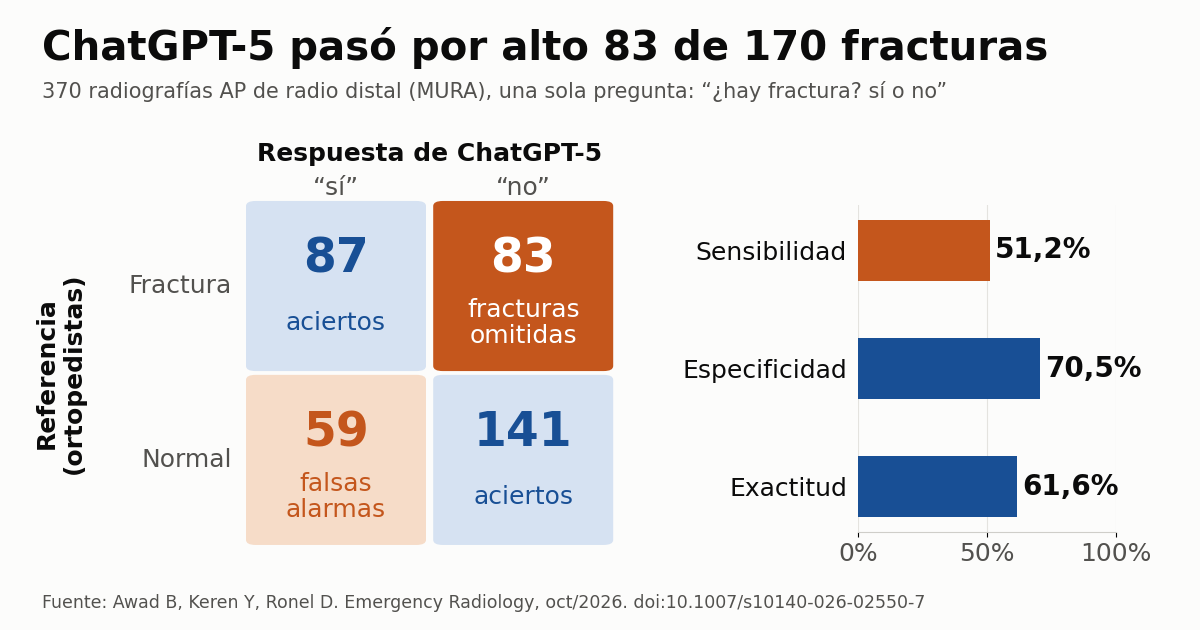
ChatGPT-5 pasó por alto 83 de 170 fracturas de radio distal en radiografías de muñeca cuando se le hizo una sola pregunta de sí o no, lo que equivale a una sensibilidad del 51,2%, según un estudio publicado el 26 de octubre en Emergency Radiology. El modelo, además, señaló fractura en 59 de 200 estudios normales. Los autores, del Rambam Health Care Campus de Haifa (Israel), concluyen que un chatbot de uso general no debe emplearse para decidir si una radiografía muestra una fractura.
Cómo se evaluó ChatGPT-5 en radiografías de muñeca
Bana Awad, Yaniv Keren y Dror Ronel tomaron las imágenes de MURA, un banco público publicado por Stanford en 2017, con 40.561 imágenes del miembro superior cuyos estudios fueron etiquetados como normales o anormales por radiólogos en la práctica clínica, usado como referencia para entrenar y comparar algoritmos. De las 3.697 proyecciones anteroposteriores (AP) de radio distal del archivo, descartaron las de mala calidad, los estudios pediátricos (la fisis abierta puede simular un trazo de fractura) y las radiografías con material de osteosíntesis. Se conservaron las imágenes tomadas a través de yeso.
Como la etiqueta de MURA se aplica al estudio completo y no precisa si hay fractura, la referencia fue otra: un residente sénior de traumatología y un traumatólogo certificado revisaron cada imagen en conjunto, antes de que llegara al modelo, y solo la incluyeron cuando coincidían en que la fractura estaba presente o ausente con certeza.
Entre el 1 de diciembre y el 28 de febrero, cada radiografía se cargó en la interfaz web pública de ChatGPT, en un chat temporal nuevo, sin instrucciones de sistema, sin ejemplos, con la memoria desactivada y la configuración por defecto. La pregunta fue siempre la misma: “¿Hay una fractura en esta radiografía? Responde sí o no.” Se hicieron 396 envíos. En 26 (6,6%) el modelo dio una respuesta evasiva y esas imágenes quedaron fuera del análisis principal, que incluyó 370 radiografías: 170 con fractura (45,9%) y 200 normales.
Sensibilidad del 51,2% y errores inclinados hacia los falsos negativos
La matriz de confusión muestra 87 fracturas detectadas y 83 omitidas; entre los estudios normales, 141 aciertos y 59 falsas alarmas. De ahí salen una sensibilidad del 51,2% (IC 95%: 43,7–58,6), una especificidad del 70,5% (63,8–76,4) y una exactitud del 61,6% (56,6–66,4). El kappa de Cohen, de 0,219, refleja una concordancia apenas aceptable con la referencia. Una prueba de McNemar post hoc confirmó que los falsos negativos superaron a los falsos positivos (χ² = 4,06; p = 0,044).
Al reincorporar las 26 respuestas evasivas, la sensibilidad osciló entre el 47,3%, si se cuentan como error o como “no”, y el 54,9%, si se tratan como “sí”, el supuesto más favorable al modelo. Proyectado a un servicio con una prevalencia de fractura del 20%, el rendimiento equivaldría, por cada mil radiografías, a 98 fracturas no detectadas y 236 falsas alarmas, con un valor predictivo positivo del 30,3%.
“Dicho sin rodeos: un chatbot de uso general no debe utilizarse para decidir si una radiografía muestra una fractura”, escriben los investigadores.
Por qué un LLM multimodal no es un detector de fracturas
La comparación obligada es con el software de detección de fracturas basado en redes neuronales convolucionales (CNN), entrenado de extremo a extremo con radiografías etiquetadas para una sola tarea. El primero de estos productos autorizado por la FDA, OsteoDetect, obtuvo la autorización De Novo en mayo de 2018 precisamente para señalar fracturas de radio distal en adultos, como apoyo —no como reemplazo— de la lectura médica. Los metaanálisis citados en el artículo sitúan la sensibilidad agrupada de esta clase de herramientas en torno al 90%. Los autores advierten que la comparación es indirecta, porque poblaciones, bases de datos y estándares de referencia difieren, pero consideran que la brecha es demasiado grande para atribuirla solo al método.
El trabajo enumera mecanismos plausibles que su diseño no permite separar. El codificador visual de un LLM multimodal está optimizado para imágenes naturales, no para interrupciones corticales sutiles en escala de grises. La pregunta binaria impide el razonamiento paso a paso y el contexto clínico que, en otros estudios, mejoraron la exactitud de estos modelos entre 5 y 15 puntos porcentuales: el resultado es un piso y no un techo. Además, la interfaz de consumo redimensiona y fragmenta las imágenes antes de que lleguen al modelo, sin documentar cómo.
El error que más pesa en el triaje de urgencias
En triaje, la dirección del error importa tanto como su frecuencia. Un falso positivo cuesta una segunda revisión o una proyección adicional; un falso negativo puede enviar a casa a un paciente con una fractura sin inmovilizar, con riesgo de desplazamiento y consolidación viciosa. Un sistema que responde “no” ante la mitad de las fracturas traslada el riesgo al lado que el triaje debería proteger. El escenario simulado es el de un médico no radiólogo que, en el punto de atención, sube la imagen y hace la pregunta más simple posible; en él, alrededor de una de cada quince consultas ni siquiera devolvió una respuesta utilizable.
En América Latina el paralelo es claro: en muchos servicios de urgencias la radiografía de muñeca la interpreta primero el médico de guardia, y el informe del radiólogo, presencial o por telerradiología, puede llegar después del alta. En ese flujo, recurrir a una aplicación de chat como segunda opinión es justamente el uso que el estudio desaconseja. El propio artículo deja constancia de que ChatGPT-5 no está autorizado como dispositivo médico para uso radiológico por la FDA, la EMA, la MHRA británica ni el Ministerio de Salud de Israel.
El resultado se suma a otras señales de cautela. Incluso las herramientas dedicadas fallan sin contexto clínico, como en el caso de la IA que marcó un neumotórax que no existía, y siete algoritmos comerciales para cáncer de pulmón en rayos X de tórax mostraron sensibilidades de entre el 21% y el 78%. Cuando un LLM justifica una respuesta equivocada, la experiencia del radiólogo es lo que evita aceptar el error, una protección que el usuario no especialista no tiene. En tareas de texto y con supervisión el panorama cambia: GPT-5 ya se usó para ayudar a los pacientes a entender el informe radiológico, y un LLM mejoró la exactitud de los residentes en RM cerebral como apoyo al razonamiento, no como juez final.
Límites del estudio y qué seguir de cerca
Los autores acotan el alcance: el hallazgo vale para esta versión del modelo, esta pregunta, esta región anatómica y esta base de datos, y no resuelve si flujos de trabajo bien diseñados con LLM pueden aportar a la imagen musculoesquelética. La referencia provino de dos traumatólogos que leyeron juntos, no de radiólogos con lecturas independientes, sin tomografía ni seguimiento para confirmar los casos. Como solo entraron radiografías que ambos consideraron inequívocas, las cifras probablemente reflejan el mejor escenario para el modelo. Cada imagen se envió una sola vez a un servicio no determinista que se actualiza de forma continua, y no se probaron otras formulaciones de la pregunta, la historia clínica ni otros modelos.
Para avanzar, el grupo propone adaptación a la tarea, diseño riguroso de la indicación y del flujo de procesamiento, comparación directa con CNN dedicadas sobre las mismas imágenes y evaluación en varias regiones anatómicas, con referencia adjudicada por radiólogos. Mientras tanto, la lectura práctica es que los detectores de fracturas validados y un chatbot conversacional son tecnologías distintas, respaldadas por evidencia distinta, y que, en palabras de los autores, tratarlos como una sola cosa “distorsionaría a ambos”.
Fuente: AuntMinnie — ChatGPT-5 misses half of distal radius fractures on x-rays. Artículo original (acceso abierto): Awad B, Keren Y, Ronel D. Performance of ChatGPT-5 under a minimal binary prompt for detection of distal radius fractures on plain radiographs. Emergency Radiology, 2026.