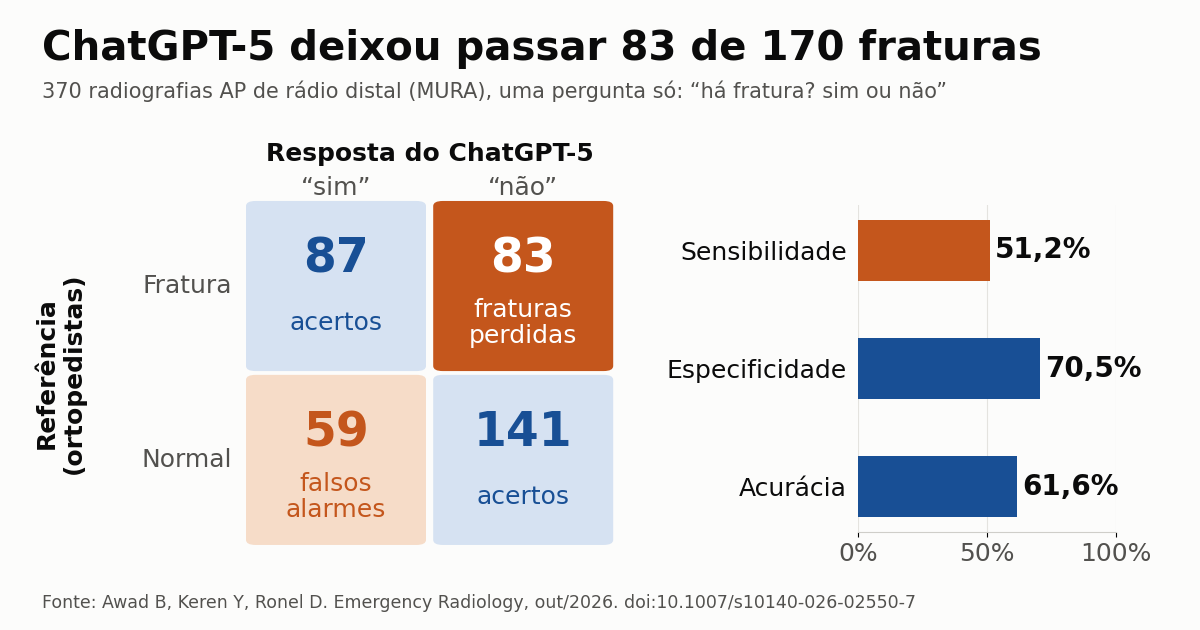
Um estudo publicado em 26 de outubro na Emergency Radiology mostra que o ChatGPT-5, consultado com uma única pergunta de sim ou não, deixou passar 83 de 170 fraturas do rádio distal em radiografias de punho — sensibilidade de 51,2%. O modelo também apontou fratura em 59 de 200 exames normais. Para os autores, do Rambam Health Care Campus, em Haifa (Israel), o resultado basta para afirmar que um chatbot de uso geral não deve ser usado para decidir se uma radiografia mostra fratura.
Como o ChatGPT-5 foi testado nas radiografias de punho
Bana Awad, Yaniv Keren e Dror Ronel partiram do MURA, banco público divulgado por Stanford em 2017, com 40.561 imagens de membro superior cujos estudos foram rotulados como normais ou anormais por radiologistas na rotina clínica, usado como referência para treinar e comparar algoritmos. Das 3.697 incidências anteroposteriores (AP) de rádio distal do acervo, ficaram de fora imagens de baixa qualidade, exames pediátricos (a fise aberta pode imitar um traço de fratura) e radiografias com material de síntese. Imagens feitas através de gesso foram mantidas.
Como o rótulo do MURA vale para o estudo inteiro e não especifica fratura, a referência foi outra: um residente sênior de ortopedia e um ortopedista titulado revisaram cada imagem em conjunto, antes de qualquer envio ao modelo, e só a incluíram quando concordavam, com certeza, que havia ou não havia fratura.
Entre 1º de dezembro e 28 de fevereiro, cada radiografia foi carregada na interface web pública do ChatGPT em uma conversa temporária nova, sem instrução de sistema, sem exemplos, com memória desativada e configuração padrão. A pergunta foi sempre a mesma: “Há uma fratura nesta radiografia? Responda sim ou não.” Foram 396 envios. Em 26 deles (6,6%) o modelo deu resposta evasiva, e essas imagens saíram da análise principal, que ficou com 370 radiografias: 170 com fratura (45,9%) e 200 normais.
Sensibilidade de 51,2% e erros concentrados nos falsos negativos
Na matriz de confusão, o ChatGPT-5 acertou 87 fraturas e deixou passar 83; entre os exames normais, acertou 141 e emitiu 59 falsos alarmes. Isso resulta em sensibilidade de 51,2% (IC 95%: 43,7–58,6), especificidade de 70,5% (63,8–76,4) e acurácia de 61,6% (56,6–66,4). O kappa de Cohen, de 0,219, indica concordância apenas razoável com a referência. Um teste de McNemar feito post hoc confirmou que os falsos negativos superaram os falsos positivos (χ² = 4,06; p = 0,044).
Recolocando na conta as 26 respostas evasivas, a sensibilidade variou de 47,3%, quando todas foram contadas como erro ou como “não”, a 54,9%, quando tratadas como “sim” — a hipótese mais favorável ao modelo. Projetado para um serviço com prevalência de 20% de fratura, o desempenho equivaleria, a cada mil radiografias, a 98 fraturas não detectadas e 236 falsos alarmes, com valor preditivo positivo de 30,3%.
“Em termos diretos: um chatbot de uso geral não deve ser usado para decidir se uma radiografia mostra uma fratura”, escrevem os pesquisadores.
Por que um LLM multimodal não é um detector de fraturas
A comparação natural é com os softwares de detecção de fraturas baseados em redes neurais convolucionais (CNN), treinados de ponta a ponta com radiografias rotuladas para uma única tarefa. O primeiro desses produtos autorizado pela FDA, o OsteoDetect, recebeu aval pela via De Novo em maio de 2018 justamente para apontar fraturas do rádio distal em adultos, como apoio — e não substituto — da leitura médica. Meta-análises citadas no artigo relatam sensibilidade agregada em torno de 90% para essa classe de ferramenta — comparação indireta, ressalvam os autores, mas com uma distância grande demais para ser atribuída só a diferenças de método.
O artigo aponta mecanismos plausíveis, que o desenho não permite separar. O codificador visual de um LLM multimodal é otimizado para imagens naturais, não para rupturas corticais sutis em tons de cinza. O prompt binário impede o raciocínio passo a passo e o contexto clínico que, em outros trabalhos, elevaram a acurácia desses modelos de 5 a 15 pontos percentuais — o resultado é um piso, não um teto. E a interface de consumo redimensiona e fatia as imagens antes de entregá-las ao modelo, sem documentar como.
O erro que mais pesa na triagem de fraturas
Em triagem, a direção do erro importa tanto quanto a taxa. Um falso positivo custa uma reavaliação ou uma incidência extra; um falso negativo pode mandar para casa um paciente com fratura sem imobilização, com risco de desvio e consolidação viciosa. Um sistema que responde “não” para metade das fraturas transfere o risco para o lado que a triagem deveria proteger. O cenário simulado é o do clínico não radiologista que, no ponto de atendimento, carrega a imagem e faz a pergunta mais simples possível — e, nele, cerca de uma em cada quinze consultas nem sequer devolveu resposta utilizável.
No Brasil, o paralelo é direto: em muitos prontos-socorros e UPAs, a radiografia de punho é interpretada primeiro pelo plantonista, e o laudo do radiologista — presencial ou por telerradiologia — pode chegar depois da alta. Nesse fluxo, usar um aplicativo de conversa como segunda opinião é exatamente o uso que o estudo desaconselha. Software com finalidade diagnóstica é enquadrado como dispositivo médico pela Anvisa (RDC 657/2022), e o próprio artigo registra que o ChatGPT-5 não é liberado para uso radiológico pela FDA, pela EMA, pela MHRA britânica nem pelo Ministério da Saúde de Israel.
O resultado se soma a outros sinais de cautela. Mesmo ferramentas dedicadas erram sem contexto clínico, como no caso da IA que apontou um pneumotórax inexistente no raio-X, e sete algoritmos comerciais para câncer de pulmão no raio-X de tórax tiveram sensibilidades entre 21% e 78%. Quando o LLM justifica uma resposta errada, é a expertise do radiologista que evita a aceitação do erro — proteção que o usuário não especialista não tem. Em tarefas de texto e sob supervisão, o quadro muda: o GPT-5 já foi usado para ajudar pacientes a entender o laudo radiológico, e um LLM elevou a acurácia de residentes na RM cerebral como apoio ao raciocínio, não como juiz final.
Limites do estudo e o que acompanhar
Os autores delimitam o alcance: o achado vale para esta versão do modelo, este prompt, esta região anatômica e esta base de dados, e não decide se fluxos bem projetados com LLMs podem contribuir para a imagem musculoesquelética. A referência veio de dois ortopedistas lendo juntos, não de radiologistas em leituras independentes, sem tomografia ou seguimento para confirmar os casos. Como só entraram radiografias que os dois consideraram inequívocas, os números tendem a representar o melhor cenário para o modelo. Cada imagem foi enviada uma única vez a um serviço não determinístico e atualizado continuamente, e não foram testados prompts alternativos, história clínica nem outros modelos.
Para avançar, o grupo pede adaptação à tarefa, desenho rigoroso de prompt e de pipeline, comparação direta com CNNs dedicadas nas mesmas imagens e avaliação em várias regiões anatômicas, com referência adjudicada por radiologistas. Até lá, a leitura prática é que detectores de fratura validados e um chatbot de conversa são tecnologias diferentes, sustentadas por evidências diferentes — e, nas palavras dos autores, tratá-los como uma coisa só “distorceria ambos”.
Fonte: AuntMinnie — ChatGPT-5 misses half of distal radius fractures on x-rays. Artigo original (acesso aberto): Awad B, Keren Y, Ronel D. Performance of ChatGPT-5 under a minimal binary prompt for detection of distal radius fractures on plain radiographs. Emergency Radiology, 2026.