Los atributos radiómicos extraídos de segmentaciones automáticas por deep learning no son intercambiables con los obtenidos de contornos manuales: en TC y RM abdominales, tres modelos públicos de segmentación generaron decenas de atributos con concordancia pobre o regular y con sesgo sistemático frente a la referencia manual, y los modelos predictivos entrenados con esos atributos mostraron, en general, peor desempeño y menor generalización. El hallazgo procede de una carta de investigación publicada el 14 de octubre de 2026 en el American Journal of Roentgenology (AJR) por investigadores del Cincinnati Children’s Hospital Medical Center, en Estados Unidos.
Qué comparó el estudio de Cincinnati
El trabajo, dirigido por Jonathan A. Dudley, PhD, del Imaging Research Center y del Departamento de Radiología del Cincinnati Children’s, con Zach Taylor, Hailong Li, Lisa Qiu, Jonathan R. Dillman y Andrew T. Trout como coautores, se publicó como research letter en AJR (doi:10.2214/AJR.26.35746). La pregunta era concreta: si la segmentación manual de órganos completos se sustituye por modelos de deep learning de acceso público, ¿siguen siendo equivalentes los atributos radiómicos y los modelos construidos con ellos?
Los autores reutilizaron dos conjuntos de datos de estudios previos. El conjunto A reunió TC abdominales axiales con contraste de 139 niños con páncreas normal. El conjunto B incluyó secuencias axiales de RM potenciadas en T2 de 64 niños y adultos jóvenes, de 7 a 24 años, con enfermedad hepática autoinmune. En cada conjunto, la segmentación manual actuó como referencia y se comparó con tres herramientas abiertas:
- Conjunto A (TC): MRSegmentator, la tarea de TC por defecto de TotalSegmentator y el modelo de TC de PaNSegNet;
- Conjunto B (RM): MRSegmentator, la tarea total_mr de TotalSegmentator y el modelo MRI_BODY de NV-Segment-CTMR.
De cada máscara se extrajeron atributos radiómicos y se evaluaron dos aspectos: la concordancia entre el valor medido en la máscara automática y en la manual (clasificada en categorías de pobre a excelente) y la presencia de sesgo, es decir, un desplazamiento sistemático al alza o a la baja. Después, los investigadores entrenaron modelos con los atributos de cada origen y compararon exactitud y generalización.
Las cifras: concordancia, sesgo y desempeño de los modelos
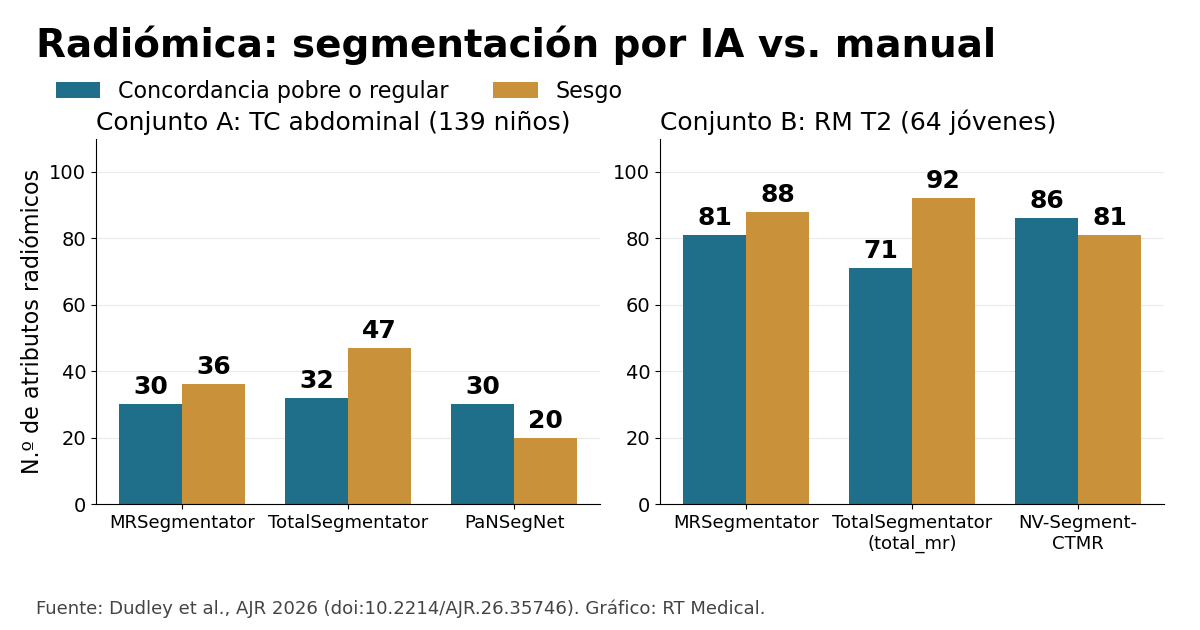
Según la cobertura de AuntMinnie sobre el artículo, los tres modelos se comportaron de forma similar dentro de cada conjunto. En la TC pediátrica (conjunto A), 30 atributos con MRSegmentator, 32 con TotalSegmentator y 30 con PaNSegNet mostraron concordancia pobre o regular con la referencia manual; 36, 47 y 20 atributos, respectivamente, presentaron sesgo. En la RM (conjunto B) el cuadro fue más marcado: 81, 71 y 86 atributos con concordancia pobre o regular para MRSegmentator, TotalSegmentator y NV-Segment-CTMR, y 88, 92 y 81 con sesgo.
Cuando esos atributos alimentaron modelos predictivos, cambiar el origen de la segmentación tuvo un costo. Frente a los modelos basados en contornos manuales, la exactitud cayó en promedio 0,05 con MRSegmentator y 0,12 con PaNSegNet; con TotalSegmentator no hubo diferencia significativa (media de −0,01). La generalización empeoró en los tres casos, con diferencias medias de 0,15 (MRSegmentator), 0,10 (TotalSegmentator) y 0,17 (PaNSegNet). El material disponible no precisa la escala exacta de estas métricas, por lo que los valores deben leerse como diferencias relativas informadas por los autores.
El grupo concluye que los atributos de máscaras generadas por deep learning muestran con frecuencia concordancia limitada y sesgo respecto de los manuales. Recomiendan que quienes desarrollan modelos radiómicos describan con claridad la metodología de segmentación y que quienes validan o comparan modelos reconozcan que las diferencias de segmentación pueden confundir los resultados.
Contexto técnico: por qué el borde de la máscara pesa tanto
Esta sección resume conocimiento general del área, no resultados del estudio. La radiómica convierte una región de interés en cientos de números. Los atributos de forma (volumen, superficie, esfericidad) dependen directamente del contorno. Los de primer orden (media, desviación estándar, asimetría, entropía del histograma) cambian cuando la máscara incluye algunos vóxeles de grasa, vaso o parénquima vecino. Los de textura, como los derivados de la matriz de coocurrencia de niveles de gris (GLCM) y de las matrices de longitud de corrida y de zonas, son especialmente sensibles porque el borde concentra los mayores gradientes de intensidad de la imagen.
Por eso, dos contornos con un coeficiente de Dice alto pueden generar atributos de textura muy distintos: el Dice mide superposición volumétrica, pero apenas registra una franja delgada de vóxeles en la periferia, justo donde reside buena parte de la información de textura. La Image Biomarker Standardisation Initiative (IBSI) estandarizó definiciones y cálculos de atributos (Zwanenburg et al., Radiology 2020), lo que reduce la variabilidad entre programas, pero no resuelve la variabilidad que introduce la propia segmentación. Notas recientes de este blog, como el modelo que lee riesgo de cáncer en TC normales y el que predice neumonitis por inmunoterapia a partir de la TC, dependen precisamente de esta cadena segmentación-atributo-modelo.
Implicaciones prácticas para radiología y radioterapia
Para los grupos de investigación, el mensaje es metodológico: mezclar máscaras manuales y automáticas en un mismo estudio, o validar externamente un modelo radiómico con segmentaciones de otro origen, puede introducir un desplazamiento sistemático que se confunde con un efecto biológico. Registrar la herramienta, la versión y la tarea de segmentación pasa a ser tan importante como registrar el protocolo de adquisición.
En radioterapia, donde el contorneo automático de órganos de riesgo ya forma parte de la rutina de muchos servicios, el estudio refuerza una idea conocida en física médica: métricas geométricas como el Dice y la distancia de Hausdorff son necesarias, pero no suficientes para juzgar si un contorno sirve para un uso posterior concreto, ya sea un histograma dosis-volumen o un biomarcador de imagen. La evaluación debe considerar el uso final y mantener una nomenclatura coherente de las estructuras, tema de nuestra guía sobre el TG-263. Cabe señalar que el estudio no evaluó contornos para planificación ni dosimetría; la extrapolación a radioterapia es contextual.
En Brasil y en América Latina, donde las cohortes radiómicas suelen armarse con datos de varios centros y herramientas abiertas, la recomendación de documentar y estandarizar la segmentación es especialmente relevante, ya que las diferencias entre hospitales pueden sumarse a las diferencias entre métodos de contorneo.
Limitaciones y próximos pasos
Se trata de una carta de investigación, con muestras moderadas, poblaciones pediátricas y de adultos jóvenes y datos retrospectivos de estudios anteriores. La segmentación manual se tomó como referencia, aunque también tiene variabilidad entre observadores. Los modelos evaluados son herramientas públicas de uso general, sin ajuste fino para los conjuntos analizados, y los hallazgos no se refieren a otras herramientas, comerciales o no. El material consultado tampoco informa el número total de atributos extraídos ni la definición exacta de las métricas de concordancia y desempeño. Como en otros modelos radiómicos recientes, la validación externa y el reporte metodológico transparente siguen siendo requisitos para el uso clínico.
Fuente: AuntMinnie